Wenn eine SRT-Bibliothek viele Streams gleichzeitig überträgt, zählen neben dem Durchsatz auch Speicherbedarf, CPU-Aufwand und das Verhalten bei Paketverlust. Schon wenige zusätzliche Bytes pro gepuffertem Paket können sich über viele Verbindungen zu einem erheblichen Ressourcenverbrauch summieren.
Bei Robotweax SRT prüfen wir diese Eigenschaften gemeinsam. Ein Beispiel aus unserer Messreihe vom 8. Oktober 2026 zeigt, wie daraus eine konkrete Verbesserung entsteht: Durch eine kleinere Metadatenstruktur im Sendepuffer sank der gemessene Prozessspeicher bei 32 Streams um rund 33,2 MiB. Der Durchsatz blieb im direkten Vergleich nahezu unverändert. Der Fix ist inzwischen in unserer Entwicklungslinie integriert.
Welche Werte wir messen
Der tatsächlich beim Empfänger angekommene Durchsatz ist unsere erste Kennzahl. Eine eingestellte Senderate beschreibt die angebotene Last. Für das Ergebnis zählen die vollständig übertragenen Nutzdaten und die dafür benötigte Zeit. Zusätzlich prüfen wir deren Inhalt: Ein Lauf besteht nur, wenn die erwarteten Daten korrekt ankommen und beide Endpunkte erfolgreich abschließen.
Den CPU-Aufwand setzen wir zur übertragenen Datenmenge ins Verhältnis. Wir addieren die vom Betriebssystem erfasste Benutzer- und System-CPU-Zeit von Sender und Empfänger und berechnen daraus CPU-Sekunden pro übertragenem Gbit. Damit wird sichtbar, ob eine Änderung für dieselbe Nutzdatenmenge mehr Rechenzeit braucht. Diese Kennzahl beschreibt CPU-Arbeit, keine Prozentanzeige der momentanen Auslastung.
Für den Speicher erfassen wir regelmäßig den RSS der beiden Prozesse. RSS steht für Resident Set Size, also den im Arbeitsspeicher residenten Anteil eines Prozesses. Unsere Vergleichskennzahl ist die Summe der höchsten beobachteten Werte von Sender und Empfänger. Die beiden Spitzen können zu verschiedenen Zeitpunkten auftreten. Deshalb ist diese Summe keine gleichzeitige Speicherspitze des Gesamtsystems. Kernel-Socketpuffer sind beispielsweise nicht Bestandteil dieser Kennzahl.
SRT-Zähler für Verluste und Wiederholungen sowie UDP-Fehler und verworfene Pakete im simulierten Netzwerk helfen, die Ergebnisse zu erklären. Die entscheidende Integritätsprüfung erfolgt an den empfangenen Nutzdaten.
Wie wir vergleichbare Messungen aufbauen
Vor dem ersten Lauf legen wir Versionen, Einstellungen, Reihenfolge und Bewertungsgrenzen fest. Die getesteten Quellstände sind eindeutig bestimmt. Wir sichern Prüfsummen der Quellarchive, Bibliotheken und Testprogramme und verwenden dieselben Compiler-Einstellungen für die verglichenen Varianten. So lässt sich später nachvollziehen, welches Programm tatsächlich gemessen wurde.
Jedes Profil besteht aus fünf Messpaaren. Innerhalb eines Paares laufen die beiden Varianten unmittelbar nacheinander; ihre Reihenfolge wechselt von Paar zu Paar. Die Messungen erfolgen seriell mit einer Pause zwischen den Läufen. Dadurch begrenzen wir Einflüsse durch konkurrierende Last und die Reihenfolge der Tests.
Für die Prozentangaben berechnen wir zunächst die Veränderung innerhalb jedes Paares und verwenden anschließend den Median der fünf Veränderungen. Der Median ist weniger empfindlich gegenüber einem einzelnen Ausreißer. Er macht aus fünf Paaren jedoch keine statistisch abgesicherte Aussage über jede denkbare Betriebsumgebung. Die einzelnen Messwerte bleiben für die Auswertung erhalten. Fehlgeschlagene Messfälle werden mit ihrem Fehler dokumentiert und nicht durch erfolgreichere Ersatzläufe ausgetauscht.
Für diese Vergleichsreihe markieren wir mehr als 10 Prozent Durchsatzverlust, mehr als 15 Prozent zusätzlichen CPU-Aufwand pro Gbit oder mehr als 15 Prozent zusätzlichen RSS als auffällige Verschlechterung. Diese Grenzen sind vorab festgelegte Kriterien für unsere Lab-Auswertung.
Welche Lastprofile wir prüfen
Die Reihe umfasst einen einzelnen Stream mit 50 Mbit/s sowie 32 parallele Streams mit insgesamt 320 Mbit/s oder 2 Gbit/s angebotener Last. Zu den sauberen Profilen kommen simulierte Netzwerkbedingungen: leichte Störungen mit 20 Millisekunden Verzögerung, 5 Millisekunden Jitter und 0,1 Prozent Paketverlust sowie stärkere Störungen mit 80 Millisekunden Verzögerung, 20 Millisekunden Jitter und 1 Prozent Verlust. Die konfigurierte SRT-Pufferlatenz wird passend zum jeweiligen Profil festgelegt und bleibt innerhalb jedes Vergleichs gleich.
Weitere Profile kombinieren AES-GCM-Verschlüsselung mit FEC, also einer Vorwärtsfehlerkorrektur. Zusätzlich vergleichen wir die optionale Session-Authentifizierung aus- und eingeschaltet am selben Kandidaten. So können wir den Aufwand einer Schutzfunktion getrennt vom Unterschied zwischen zwei Bibliotheksversionen betrachten.
In diesem Beispiel ergeben sich 120 reguläre Messfälle: 70 Fälle für den Vergleich mit einem älteren Referenzstand unserer eigenen Bibliothek, 20 Fälle für Session-Authentifizierung aus/an und 30 Fälle für den direkten Vergleich des Speicher-Fixes mit seinem unmittelbaren Vorgängerstand.
Vom Speicherbefund zur Änderung
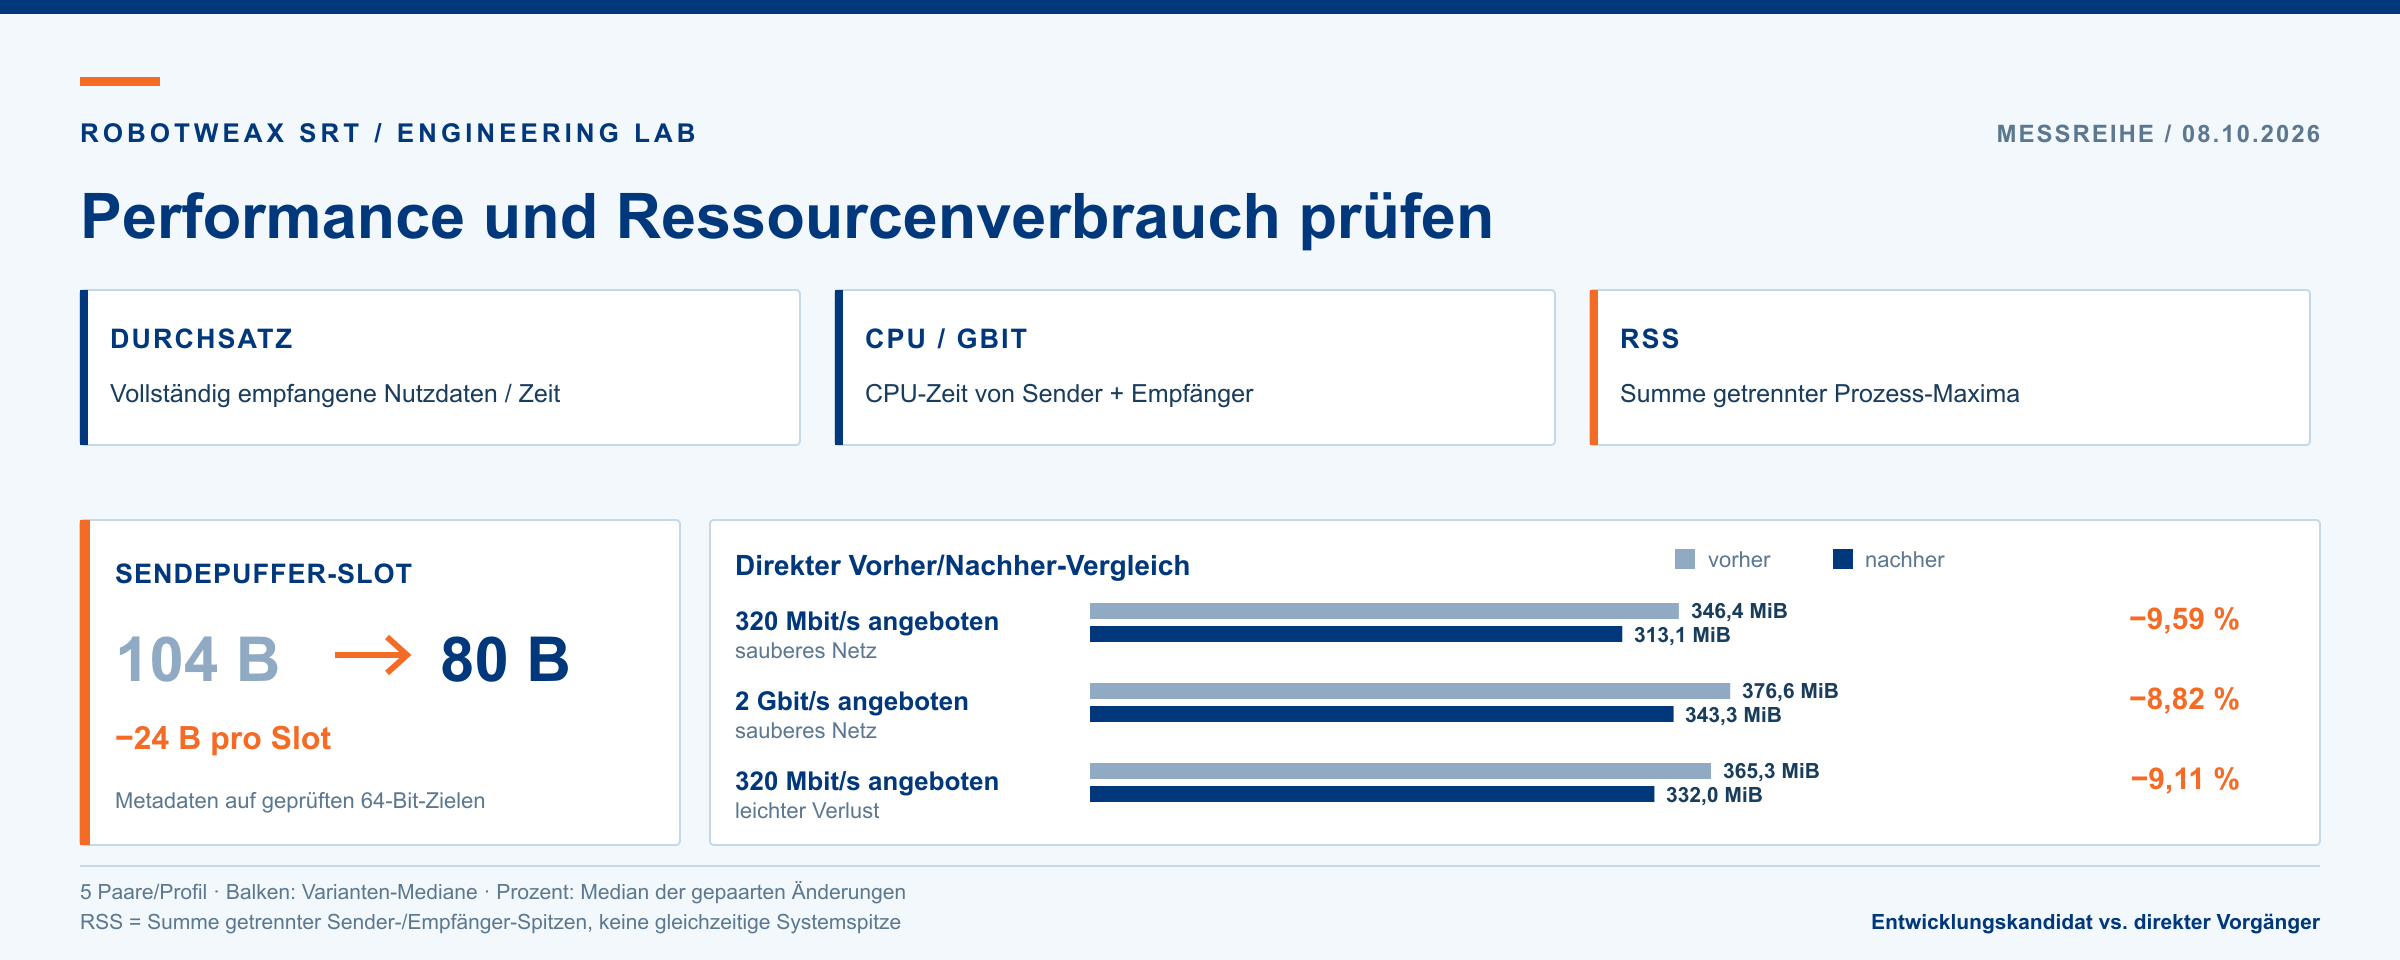
Eine frühere Vergleichsreihe hatte einen auffälligen RSS-Mehrverbrauch gezeigt. Bei der Untersuchung fiel eine Metadatenstruktur im Sendepuffer auf: Sie belegte auf den geprüften 64-Bit-Zielen 104 Byte pro Slot. Ein Slot verwaltet die Informationen zu einem Paket im Sendefenster.
Die Struktur reservierte gleichzeitig Platz für Zeitstempel eines noch aktiven Pakets und für Informationen zu einem bereits verworfenen Paket. Diese Zustände schließen sich gegenseitig aus. Wir konnten ihren Speicher daher gemeinsam nutzen und die übrigen Felder günstiger anordnen. Die Struktur schrumpfte von 104 auf 80 Byte, also um 24 Byte pro Slot.
Die Übergänge zwischen den Zuständen bleiben ausdrücklich definiert und getestet. Fenstergrößen, vollständige Zeitstempel und Zähler, Nutzdatenpuffer, Wiederholungsbudgets und die öffentliche C-Schnittstelle bleiben erhalten. Eine Prüfung beim Kompilieren schützt das neue Größenbudget. Regressionstests decken unter anderem Kopieren, teilweise bestätigte Nachrichten, Sequenznummernüberlauf, Ablaufzeiten und die wiederholte Wiederverwendung eines Slots ab.
Was der direkte Vergleich zeigt
Um die Wirkung dieser Änderung zu isolieren, vergleichen wir den Kandidaten mit dem unmittelbar vorhergehenden Entwicklungsstand. Bei identischer Konfiguration ergeben sich folgende Werte:
| Profil mit 32 Streams | RSS vorher | RSS nachher | Median der gepaarten RSS-Veränderungen |
|---|---|---|---|
| 320 Mbit/s angeboten, sauberes Netzwerk | 346,4 MiB | 313,1 MiB | −9,59 % |
| 2 Gbit/s angeboten, sauberes Netzwerk | 376,6 MiB | 343,3 MiB | −8,82 % |
| 320 Mbit/s angeboten, leichter Paketverlust | 365,3 MiB | 332,0 MiB | −9,11 % |
Die RSS-Spalten zeigen die Mediane der jeweiligen Variante. Die Prozentwerte stammen aus den fünf einzelnen Messpaaren und können deshalb vom Verhältnis der beiden Tabellenmediane abweichen. MiB bezeichnet Mebibyte; ein MiB entspricht 1.048.576 Byte.
In allen drei Profilen sinkt der gemessene Speicherbedarf um ungefähr 33,2 MiB. Das passt zur erwarteten Einsparung aus dem kleineren Slot-Layout. Der CPU-Aufwand pro Gbit steigt im ungünstigsten dieser gepaarten Vergleiche um rund 0,91 Prozent. Die größte Durchsatzabnahme beträgt rund 0,10 Prozent.
Der zusätzliche Vergleich mit einem älteren Referenzstand unserer Bibliothek beantwortet eine andere Frage: Wie steht die aktuelle Entwicklung insgesamt gegenüber diesem Stand da? Über die sieben Profile ohne Session-Authentifizierung liegt der RSS-Mehrverbrauch nun bei etwa 2,2 bis 4,94 Prozent. Der CPU-Aufwand pro Gbit steigt höchstens um rund 4,32 Prozent; der größte Durchsatzverlust beträgt rund 0,23 Prozent. Alle Werte liegen unter den zuvor festgelegten Auffälligkeitsgrenzen.
Die separat geprüfte Session-Authentifizierung erhöht den RSS gegenüber derselben Variante ohne diese Funktion um etwa 0,24 bis 0,27 Prozent und den CPU-Aufwand pro Gbit um 4,35 bis 5,80 Prozent. Auch solche zusätzlichen Kosten gehören zur Bewertung einer Funktion.
Wie wir gesunde Streams unter Störungen prüfen
Ein weiterer Test untersucht zwei Verbindungen auf demselben UDP-Listener. Eine Verbindung erhält absichtlich ungünstige Bedingungen und wiederholte NAKs. NAKs sind Rückmeldungen, mit denen fehlende Pakete zur erneuten Übertragung angefordert werden. Gleichzeitig soll eine gesunde Verbindung ihre Daten weiter zuverlässig übertragen.
Wir prüfen Fenstergrößen von 8.192 und 65.536 Paketen, jeweils mit Kontrollfällen ohne NAK-Flut und mit 5.000 NAKs pro Sekunde. Neben den Nutzdaten kontrollieren wir, ob die geplante Flut tatsächlich angeboten und vom Sender verarbeitet wurde.
Der Kandidat besteht alle 20 eigenen Fälle; der gesunde Stream erreicht ungefähr seine vorgesehenen 50 Mbit/s. Der ältere Referenzstand besteht 15 von 20 Fällen. Seine fünf Timeouts bei großem Fenster unter Flutlast bleiben Bestandteil des Ergebnisses. Für diese unvollständigen Vergleichspaare geben wir keine relativen Leistungswerte an.
Wie wir die Messungen absichern
Vor der Performance-Auswertung durchläuft die Änderung funktionale Prüfungen. Im Beispiel bestehen jeweils 76 CTest-Prüfungen im Debug-Build und mit AddressSanitizer und UndefinedBehaviorSanitizer sowie 783 Python-Tests. Weitere 14 Szenarien prüfen die Interoperabilität mit einem vorgebauten Haivision-SRT-1.5.7-Referenzprogramm. Dieser Referenztest prüft die Zusammenarbeit der Implementierungen; die Performance-Vergleiche verwenden ausschließlich Stände unserer eigenen Bibliothek.
Alle 120 regulären Messfälle bestehen anschließend die unabhängige Prüfung der Nutzdaten, Prüfsummen, getesteten Programmstände und des wiederhergestellten Netzwerkzustands. Die Auswertung lässt sich aus den archivierten Rohdaten identisch reproduzieren. Das erforderliche GitHub-CI-Gate des geprüften PR-Stands ist grün; optionale Jobs wurden zum Teil planmäßig übersprungen. Die Änderung am Sendepuffer ist öffentlich nachvollziehbar.
Was diese Ergebnisse für den Einsatz bedeuten
Die Messungen stammen aus einem Linux-Lab auf ARM64 mit vier virtuellen CPUs und sechs GiB Arbeitsspeicher. Sender und Empfänger kommunizieren über Loopback; Verzögerung und Verlust werden künstlich erzeugt. Die Profile verwenden zehn Sekunden angebotene Senderlast. Beim Profil mit 2 Gbit/s angebotener Last erreicht der Empfänger tatsächlich ungefähr 1,7 Gbit/s.
Diese Umgebung eignet sich, um Ressourcenunterschiede unter kontrollierten Bedingungen sichtbar zu machen. Für einen konkreten Einsatz müssen zusätzlich dessen Hardware, Netzwerkschnittstellen, Streamkonfiguration und Laufzeiten geprüft werden. Aus der kurzen Lab-Reihe lässt sich keine Freigabe für jede Produktionsumgebung ableiten.
Der Speicher-Fix zeigt, wie wir Optimierungen bewerten: Wir verbinden einen konkreten Befund im Code mit einem direkten Vorher/Nachher-Vergleich, prüfen die korrekte Übertragung und betrachten zusätzliche Schutzfunktionen sowie Störfälle. So können wir eine Einsparung von rund 33,2 MiB benennen und zugleich angeben, unter welchen Bedingungen sie gemessen wurde.